


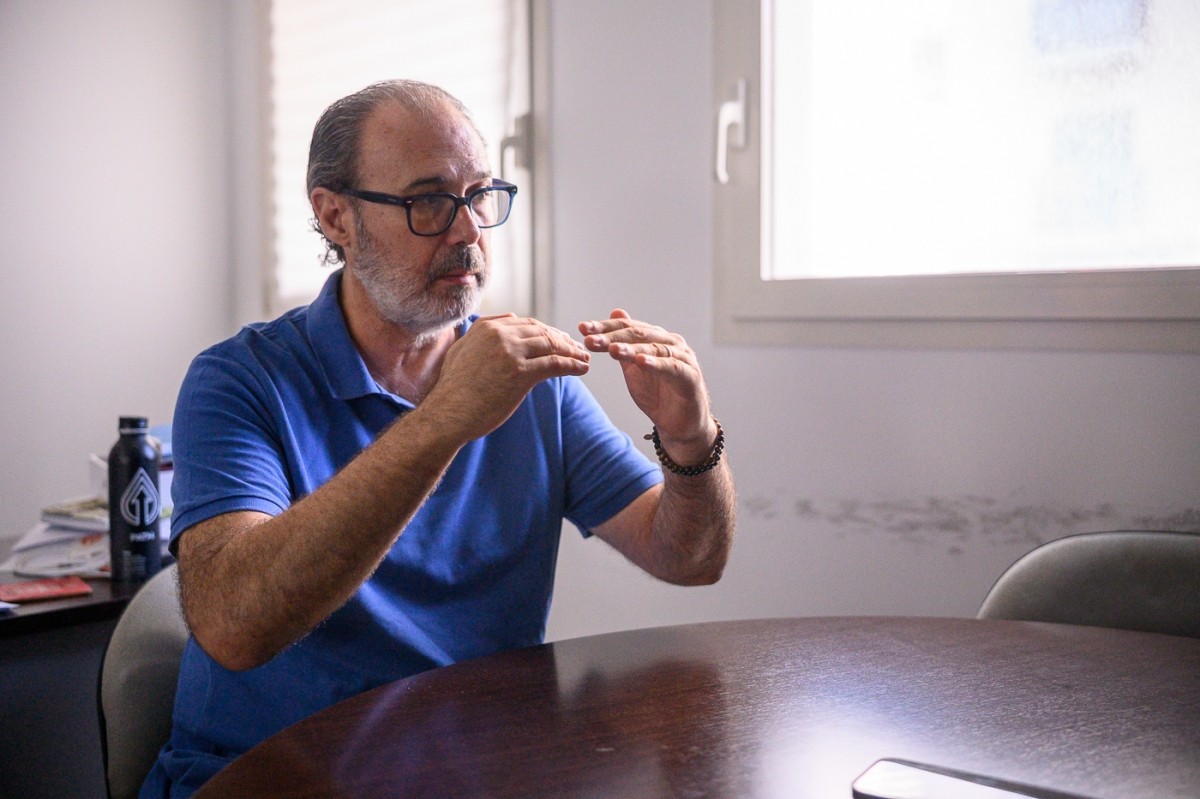
VALÈNCIA. Traducir instrucciones de uso y mantenimiento mientras trabajaba en la industria llevó a Manuel Herranz a identificar una contradicción que acabaría marcando su trayectoria profesional. Las fábricas eran capaces de construir máquinas que fabricaban otras máquinas, pero traducir de un idioma a otro la documentación técnica seguía siendo un proceso lento y tedioso. De aquella frustración nació la idea que, con el tiempo, daría lugar a Pangeanic, una compañía valenciana que comenzó en el mundo de la traducción y que hoy ayuda a empresas, laboratorios y administraciones públicas a construir sistemas de inteligencia artificial multilingües mediante datos fiables y despliegues soberanos.
"Hacíamos máquinas que hacían máquinas, pero una cosa tan simple como traducir la documentación, sin ninguna imaginación porque eran instrucciones de uso y mantenimiento, era un sufrimiento", recuerda su fundador y consejero delegado. Más de dos décadas después, la empresa trabaja en la recopilación, preparación y evaluación de datos para entrenar modelos de IA, desarrolla sistemas internos de consulta sobre documentación corporativa y participa en proyectos relacionados con la traducción automática, la voz, la clasificación de información y el aprendizaje automático.
El origen de Pangeanic se encuentra muy lejos del actual auge de la inteligencia artificial generativa. Herranz pasó varios años en Reino Unido, donde trabajó en el mundo industrial. En Ford participó en la puesta en marcha de una planta de motores, posteriormente trabajó para Rolls-Royce, donde su conocimiento de idiomas hizo que asumiera con frecuencia las sesiones de formación y la traducción de materiales técnicos y tras finalizar su contrato entró en contacto con la japonesa B.I. Corporation, especializada en traducir la documentación de los dispositivos electrónicos fabricados por compañías como Sony o Pioneer. Herranz asumió la dirección de su rama europea y terminó asociándose con la firma. A finales de 2000 regresó a España y fundó la empresa como filial de la compañía nipona. En 2005 emprendió el camino en solitario.
El encuentro con la UPV que cambió la empresa
El siguiente salto llegó cuando conoció a Francisco Casacuberta y Enrique Vidal, investigadores vinculados a la Universitat Politècnica de València (UPV) que posteriormente fueron reconocidos con premios nacionales de Informática. Ambos trabajaban en la aplicación de procesos estadísticos al lenguaje, una tecnología que despertó el interés de Herranz y abrió una nueva etapa para Pangeanic. "Me enseñaron unas cosas muy interesantes en las que estaban trabajando, procesos estadísticos aplicados al lenguaje", explica. La compañía comenzó entonces a colaborar en un primer proyecto en el que las matemáticas se combinaban con el reconocimiento de patrones lingüísticos. Los sistemas ofrecían buenos resultados, especialmente entre lenguas de una misma familia como el español, el inglés, el italiano o el francés.
"Esa fue la semilla de lo que ahora es la inteligencia artificial", recuerda Herranz. Pangeanic procedía de la traducción automática, pero en la práctica llevaba años entrenando y utilizando modelos de lenguaje mucho antes de que los grandes modelos generativos popularizaran esta tecnología. "Nosotros venimos del mundo de la traducción automática, por lo que modelos de lenguaje hemos tenido un montón", señala. La empresa fue desplazando progresivamente su actividad desde los servicios tradicionales de traducción hacia el desarrollo tecnológico, el procesamiento del lenguaje natural y la preparación de los datos necesarios para alimentar los sistemas automáticos.
Más de 500 combinaciones lingüísticas
En 2017, Pangeanic logró su primer proyecto europeo de traducción automática de alta tecnología. El objetivo era construir una infraestructura que distribuyera motores de traducción para apoyar las comunicaciones de la Unión Europea. Posteriormente, la firma consiguió un segundo proyecto para alimentar esa plataforma y participó en NTEU (Neural Translation for the EU), una iniciativa destinada a desarrollar motores neuronales para las lenguas oficiales comunitarias. Hasta entonces, buena parte de los sistemas de traducción automática utilizaban el inglés como idioma intermedio. Para trasladar un texto del español a otra lengua era habitual traducirlo primero al inglés y, desde ahí, al idioma de destino, un proceso que podía incorporar errores y reducir la precisión del resultado.
Pangeanic aprovechó las bases de datos de traducciones anteriores de la Unión Europea y sus propios recursos lingüísticos para crear, junto con otras dos empresas, motores que realizaban la traducción directamente entre distintos pares de idiomas. "Hicimos algo revolucionario y creamos motores directos. Fueron 526 combinaciones", destaca Herranz. El proyecto impulsó el crecimiento de la compañía y puso en valor un área de actividad que hasta entonces su fundador no había considerado el principal elemento diferencial del negocio: la gestión de los datos. Entrenar centenares de motores obligó a recopilar, limpiar, estructurar y validar enormes volúmenes de información multilingüe.
Datos para Microsoft y Apple
"La empresa despegó y se nos empezó a conocer por una cosa a la que yo nunca le había prestado mucha atención, que era la gestión de los datos y que ahora tiene mucha relevancia", reconoce. Aquella experiencia colocó a Pangeanic en el radar de las grandes compañías tecnológicas que trataban de competir con Google en el desarrollo de herramientas lingüísticas. "Haber gestionado tantos datos para tantos entrenamientos nos puso en el radar de grandes tecnológicas como Apple o Amazon para sus iniciativas de traducción automática. Casi ganábamos más con la venta de datos para entrenar redes neuronales que haciendo trabajos de ingeniería", apunta.
Actualmente, una parte relevante de Pangeanic está especializada en la recopilación y preparación de datos para sistemas de inteligencia artificial. La compañía trabaja para empresas medianas y para algunas de las grandes tecnológicas, entre ellas Microsoft y Apple, además de colaborar con laboratorios y administraciones públicas. Su actividad abarca desde conjuntos de datos multilingües hasta información de voz y recursos multimodales para entrenar, evaluar y alinear modelos. La empresa también genera conversaciones sintéticas que reproducen escenarios reales, como intercambios médicos, sin utilizar comunicaciones auténticas de pacientes. "Nos hemos especializado mucho en la recolección de datos para sistemas más complejos, incluso de voz. Podemos generar, por ejemplo, conversaciones médicas que no son reales, sino sintéticas, pero que se comportan como si lo fueran", explica Herranz.
Una IA que no salga de España ni de Europa
La soberanía tecnológica constituye otra de las principales líneas de negocio de la compañía. Pangeanic ganó hace años su primer contrato con la Agencia Tributaria y dispone en Paterna de una infraestructura protegida para desarrollar y probar sistemas que trabajan con información sensible. "Tenemos un sistema bunquerizado en Paterna donde hacemos los experimentos y damos servicio cuando la IA tiene que ser soberana, cuando los datos no pueden salir de España o de la Unión Europea", señala su fundador. Este tipo de despliegues permite a empresas y organismos públicos utilizar sistemas de inteligencia artificial sin enviar su documentación a plataformas externas. Pangeanic también crea chats internos capaces de consultar y responder a partir de los archivos de cada organización, además de herramientas para traducir documentos, clasificar noticias, anonimizar información o estructurar grandes volúmenes de datos.
La compañía coordinó, por ejemplo, el proyecto europeo MAPA, que desarrolló herramientas de anonimización de información médica y legal para los idiomas oficiales de la Unión Europea. La tecnología permite detectar y ocultar datos personales antes de que la documentación se emplee en investigaciones, procesos administrativos o entrenamientos de IA. En 2024, la tecnológica valenciana también resultó adjudicataria de servicios para la traducción, transcripción y subtitulación de las lenguas cooficiales en el Congreso de los Diputados. El sistema combina inteligencia artificial y revisión humana para procesar las intervenciones en catalán, gallego y euskera.
Su participación en proyectos europeos continúa con iniciativas como MOSAIC MEDIA, desarrollada entre 2024 y 2026 para facilitar que las radiotelevisiones europeas transcriban, traduzcan y subtitulen automáticamente sus contenidos. En el proyecto participan medios como 3Cat, la radiotelevisión pública eslovena RTV SLO, la belga VRT y Deutsche Welle.
La nueva frontera: enseñar a las máquinas el mundo físico
Herranz considera que los asistentes conversacionales se aproximan a una fase de madurez en la que las mejoras serán cada vez menos llamativas. La siguiente gran transformación, sostiene, llegará con los sistemas que sean capaces de interpretar el entorno y actuar sobre él. Es decir, con una inteligencia artificial que no solo procese textos, imágenes o voces, sino que también aprenda de experiencias físicas. "Los chatbots empiezan a llegar a un punto en el que no dan más de sí. La gran ayuda al ser humano está ahora en la ayuda física y se está recolectando una gran cantidad de datos de experiencias táctiles para robots", explica.
Entrenar esos sistemas requiere registrar cómo realizan las personas tareas cotidianas. Algunos proyectos utilizan cámaras colocadas en la cabeza de personas para captar el movimiento de las manos y documentar procesos como cocinar una tortilla, planchar una prenda o manipular una herramienta. Las grabaciones permiten que los robots aprendan no solo el resultado final, sino la secuencia de movimientos y decisiones necesaria para alcanzarlo. "Es muy complejo, porque no todas las decisiones que se toman son estándar. Hay personas que llevan cámaras en la cabeza mientras hacen tareas y así se ven las manos y todo el proceso. Los chinos son los que más avanzados están", asegura Herranz.
Pangeanic también trabaja con técnicas de aprendizaje automático que permiten recalibrar los modelos con datos captados en tiempo real. La información puede proceder de cámaras, sensores táctiles, sistemas de voz o dispositivos que observan el tráfico. "Esa es la nueva frontera de la IA: recalibrarse con datos que obtiene táctilmente, visualmente o a viva voz in situ", sostiene.
El avance de los modelos abre, al mismo tiempo, un mercado relacionado con la confianza. Ya no basta con que un sistema genere una respuesta: empresas y administraciones necesitan saber si la información es correcta, si respeta sus normas, si contiene sesgos o si debe ser revisada por una persona. Ahí es donde Pangeanic aspira a competir frente a compañías de mayor tamaño. Su experiencia en datos, procesos lingüísticos y evaluación le permite construir capas de control que actúan como jueces de los sistemas automáticos. Estas herramientas combinan técnicas de ingeniería y estadística con agentes especializados que valoran la fiabilidad de las respuestas y derivan a un humano aquellas decisiones sobre las que no existe suficiente certeza. "Todo el trabajo de la IA está ahora en las capas de confianza. Empresas como nosotros podemos competir en ser los jueces, con procesos de ingeniería, estadísticos y jueces agénticos. Podemos garantizar una respuesta o, si no, decirte que la revises tú", afirma Herranz.


